在深度学习的演进历程中,神经网络权重的生成与参数优化长期由基于梯度的反向传播算法(如 Adam、Muon)或强化学习(PPO、GRPO)主导。这种范式将包含数亿至数千亿参数的网络视为连续的高维黑盒,依赖海量标注数据或环境反馈进行非线性拟合。
然而,在不依赖全量反向传播的前提下,学术界一直在探索对权重空间进行结构化表征、定向编辑与静态折叠的可行性。在分析 MIT CSAIL 提出的“权重空间编程”(Weight-Space Programming, WSP)之前,有必要系统梳理此前在该领域形成的四条主流技术脉络,明确其在具体模型上的实测数据、所针对的具体问题以及各自面对的物理约束边界。
一、超网络与权重空间学习:参数流形的黑盒映射
超网络(Hypernetworks)技术早在 2017 年由 David Ha 等人提出,基本思路是通过构建辅助神经网络来直接预测或生成目标主干网络的参数矩阵。
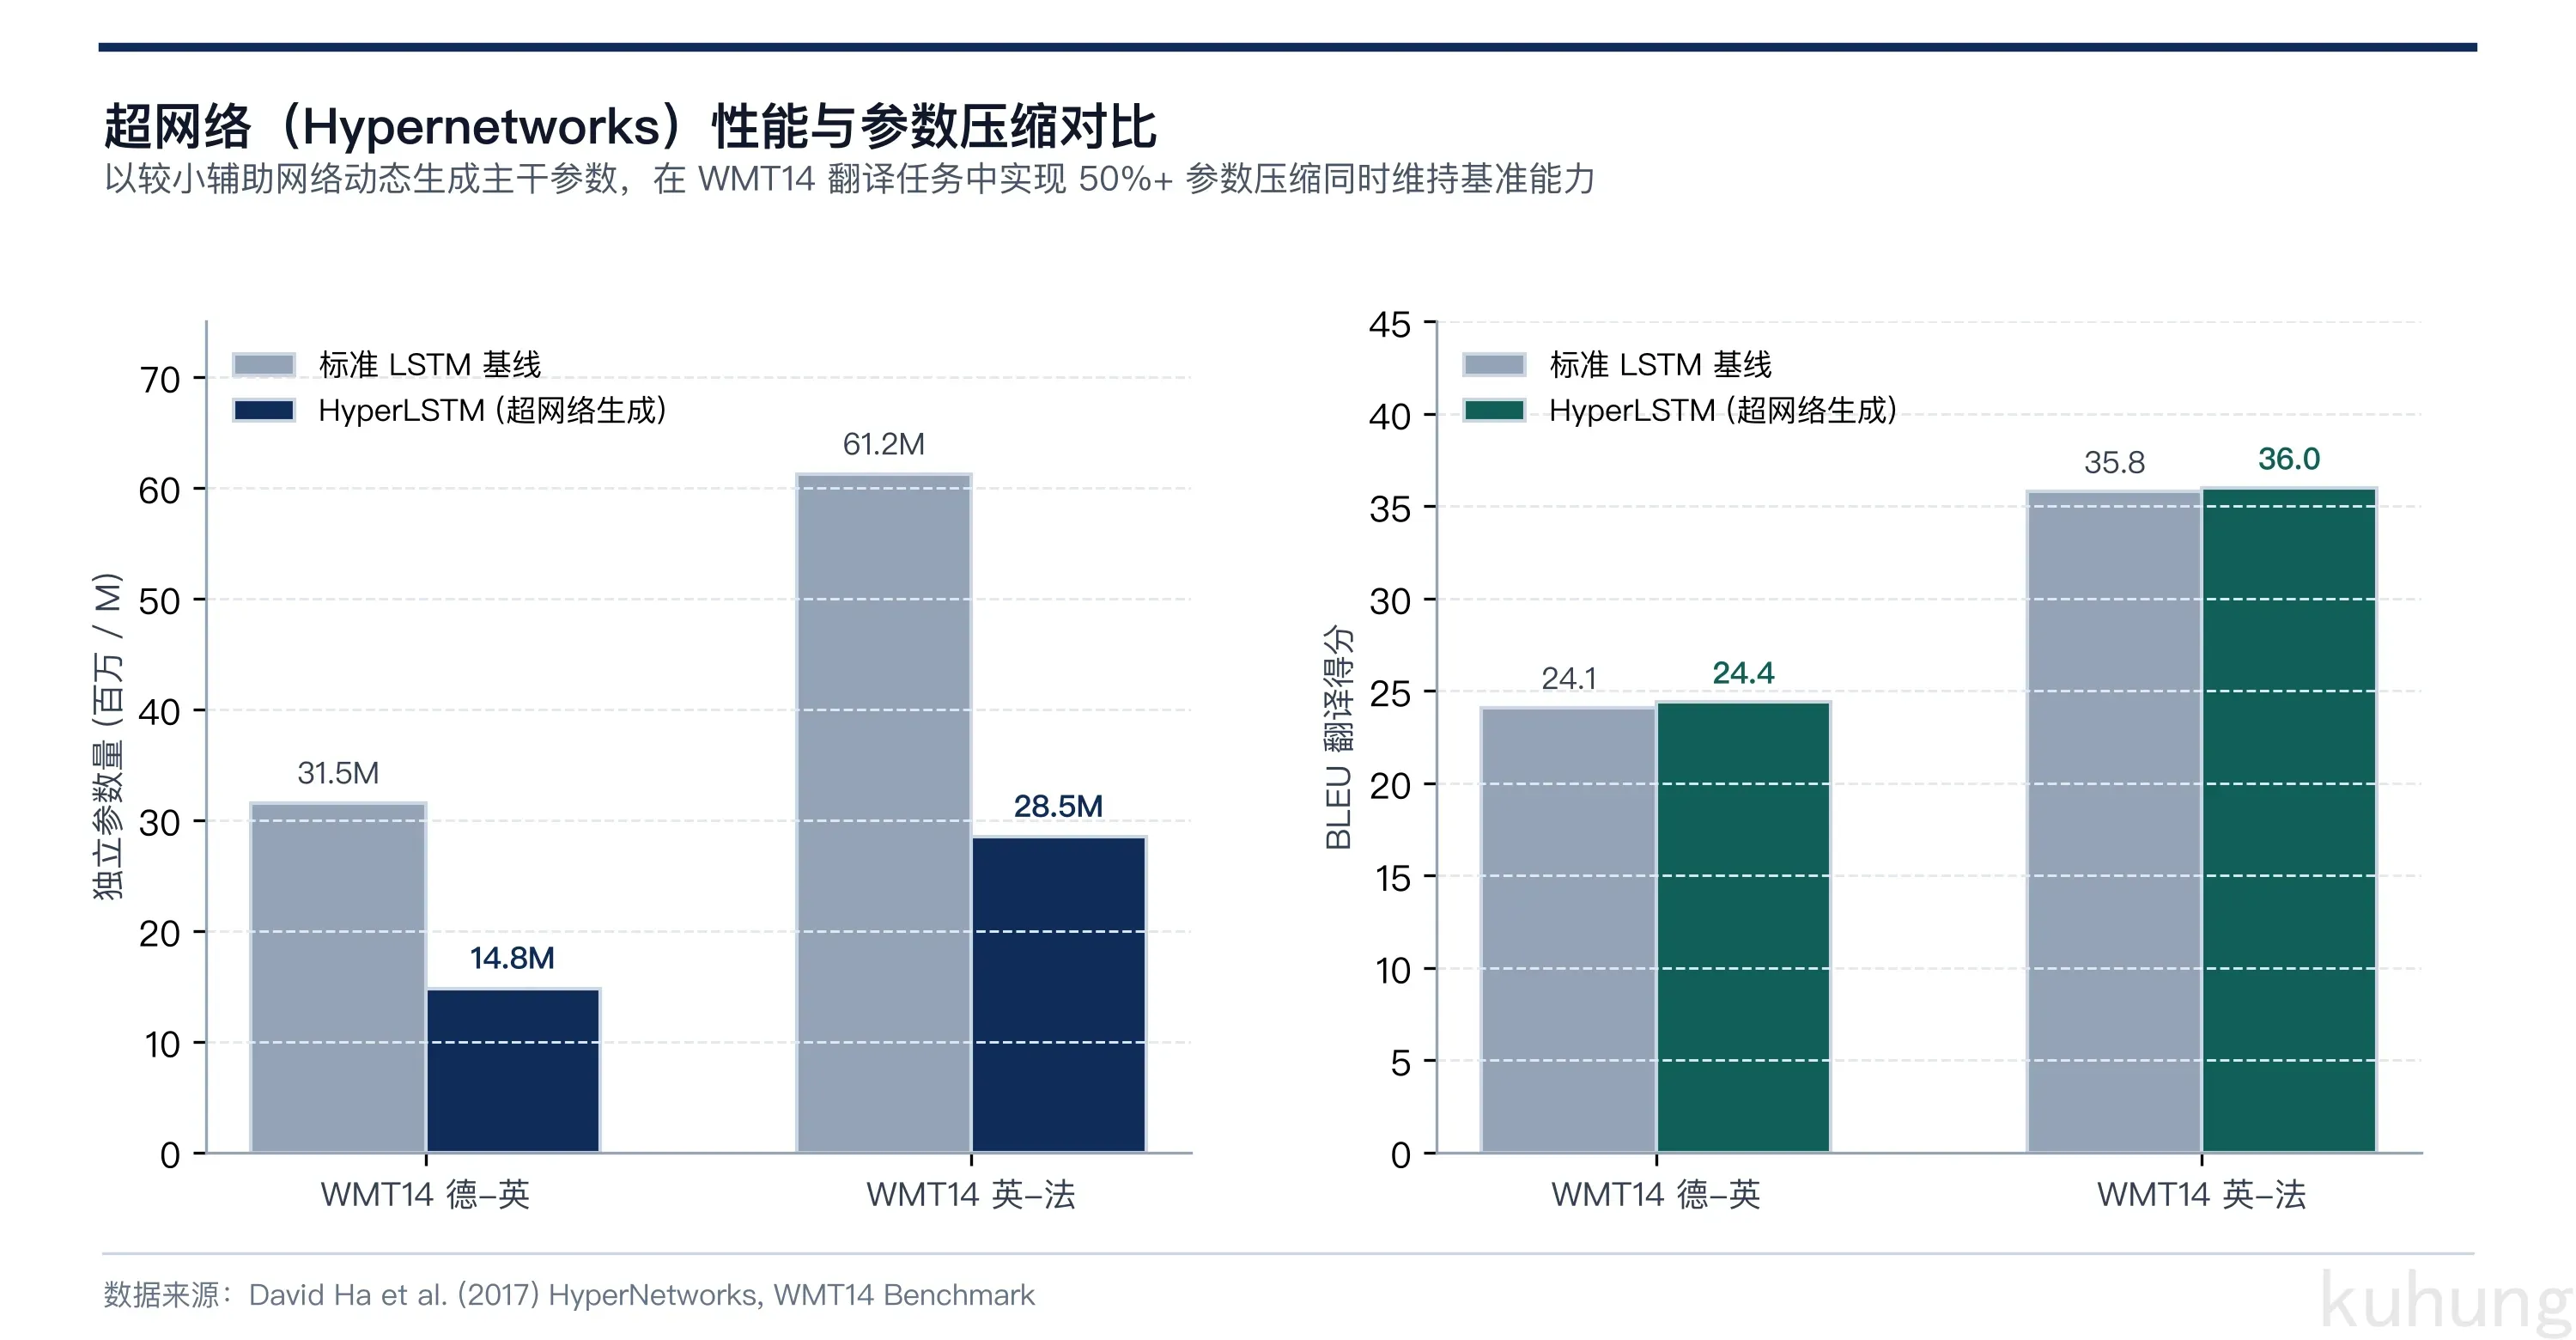
在早期的基准测试中,研究人员验证了利用 HyperLSTM 动态生成循环单元权重的有效性。在 WMT14 德英与英法机器翻译任务中,HyperLSTM 将主干网络的独立参数量分别由 31.5M 和 61.2M 压缩至 14.8M 与 28.5M(压缩比例超过 50%),同时在测试集上的 BLEU 评分维持在 24.4 与 36.0,与未压缩的标准基线持平或略有提升。
近年来,这一方向进一步拓展为“权重空间学习”(Weight Space Learning)。研究发现,多层感知机与卷积网络的参数空间并非各向同性的随机分布,而是具备严格的几何流形特征,包括神经元置换下的排列不变性(Permutation Invariance)和层间缩放等变性(Scaling Equivariance)。利用这些对称性约束,学术界相继提出了深度权重空间网络(DWSNets)与神经泛函 Transformer(NFTs)。在 ARC-1D 基准测试以及隐式神经表示(INRs)的分类与检索实验中,此类方法能够基于少量输入特征,零样本预测微型目标网络的泛化误差与收敛属性。
但超网络体系的根本局限在于学习范式:它本质上仍是监督学习架构下的高维回归映射,高度依赖海量已训练模型的参数集作为元学习(Meta-learning)训练样本,并未建立对网络参数内部算法逻辑的显式推理机制。
二、模型编辑:因果追踪与单秩事实注入
模型编辑(Model Editing)旨在不重新训练整个模型的前提下,高保真度地修正模型参数中存储的特定事实陈述(如将“埃菲尔铁塔位于巴黎”更正为“位于罗马”)。
代表性方法为 Kevin Meng 等人于 2022 年提出的 ROME(Rank-One Model Editing)。ROME 利用因果追踪(Causal Tracing)对输入 token 进行高斯噪声污染,并通过逐层激活阻断,定位出 Transformer 中间层前馈网络(MLP)是存储主谓宾关联记忆的主体。在定位到具体投影层(如 GPT-J 6B 的第 6 层 MLP)后,算法通过构造线性联想记忆方程并求解闭式最小二乘问题,计算出一个秩为 1(Rank-1)的外积矩阵直接叠加到权重张量中。
在包含 21,911 条事实陈述的 CounterFact 评估基准上,ROME 在 GPT-2 XL(1.5B)与开源 GPT-J(6B)上取得了 99.8% 的单点编辑有效性(Efficacy),同时保持了 85.4% 的事实特异性(Specificity),即未编辑的关联事实未出现语义漂移。
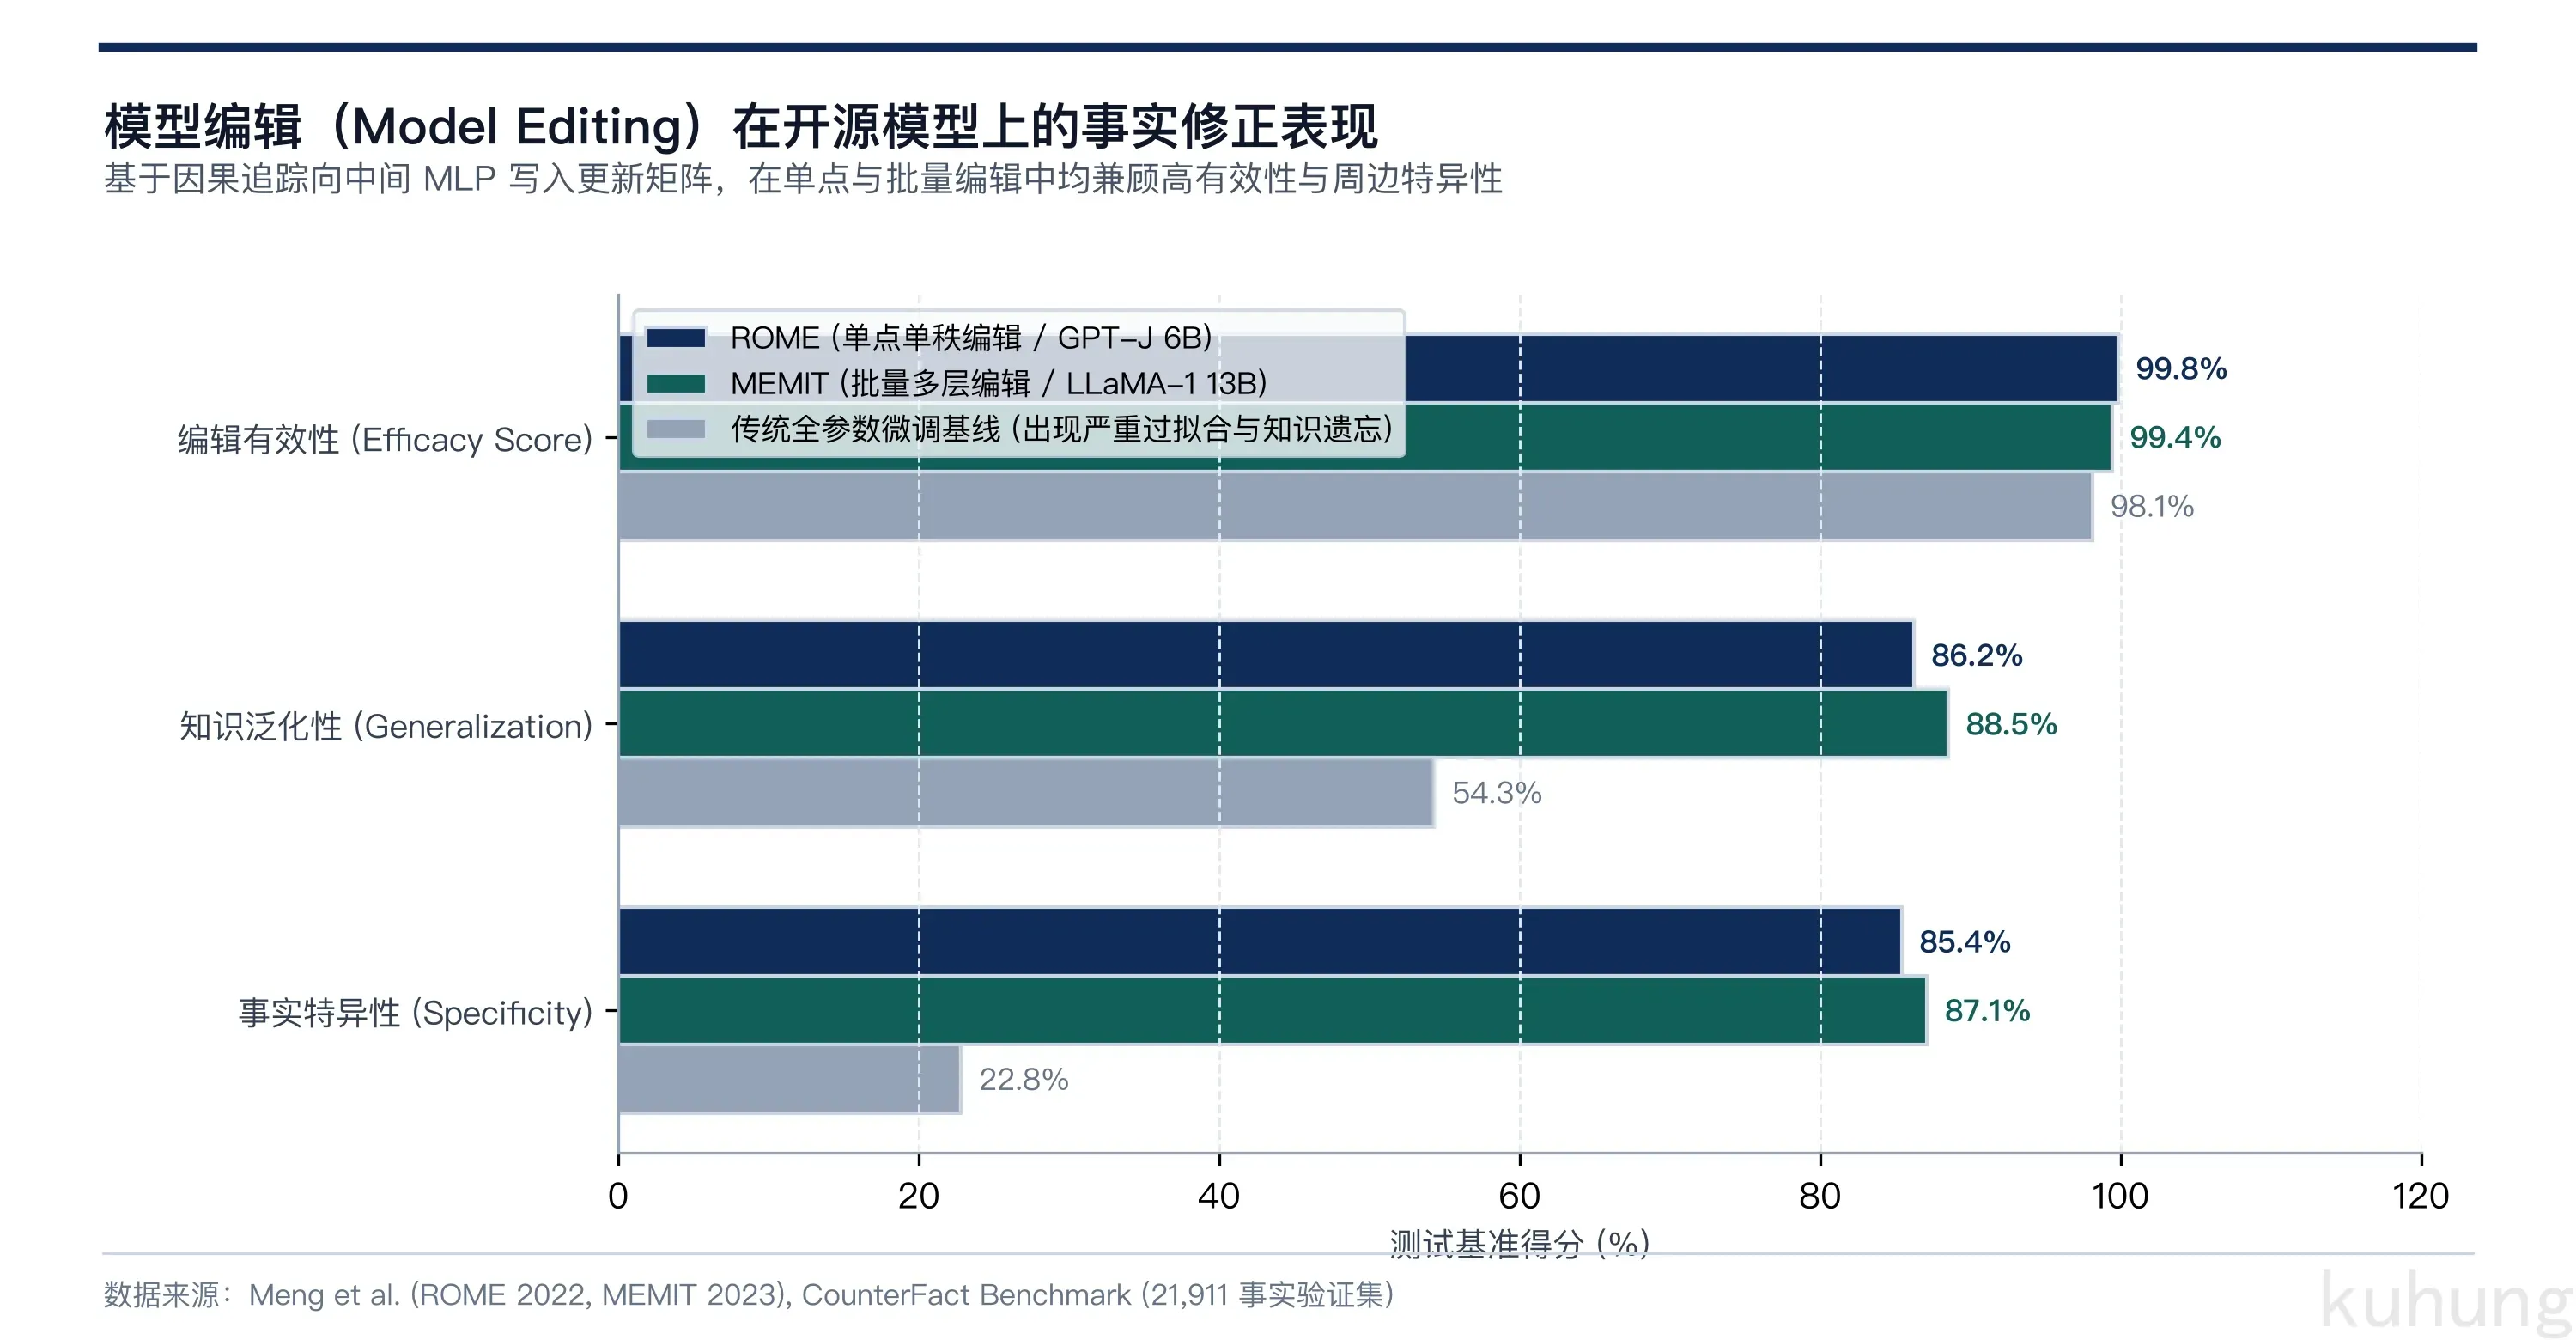
此后演进出的 MEMIT(Mass-Editing Memory in a Transformer)进一步将闭式求解拓展至深层 MLP 的联合残差分配,在 LLaMA-1 7B/13B 模型上实现了数千条事实的单次批量注入。T-Patcher 与 SCEN 等方法则通过在全连接层动态引入外挂神经元或轻量级激活补丁,规避修改原始参数带来的灾难性遗忘。
尽管模型编辑在单一事实修正上收敛稳定,但其干预范围严格受制于主谓宾三元组的显式检索关系。面对推理死循环、多步代数运算等涉及网络动态状态流转的算法逻辑缺陷,外部闭式求解矩阵无法提供有效的干预解。
三、模型汤:参数空间的贪婪几何平均
在提升模型分布外鲁棒性与泛化能力的路径上,模型汤(Model Soups)采用了一种不改变推理计算图的参数空间平均方法。
模型汤的具体做法是:基于同一个经过充分预训练的基础模型检查点,在相同的微调任务上采用不同的超参数(如学习率、权重衰减、数据增强策略或随机种子)独立训练出若干组微调权重。随后,不进行任何模型集成(Ensemble),而是对这些微调后的权重张量进行逐元素的加权算术平均。方法包括无差别的全量平均(Uniform Soup)以及在验证集上按贪婪算法逐步吸纳正向检查点的子集平均(Greedy Soup)。
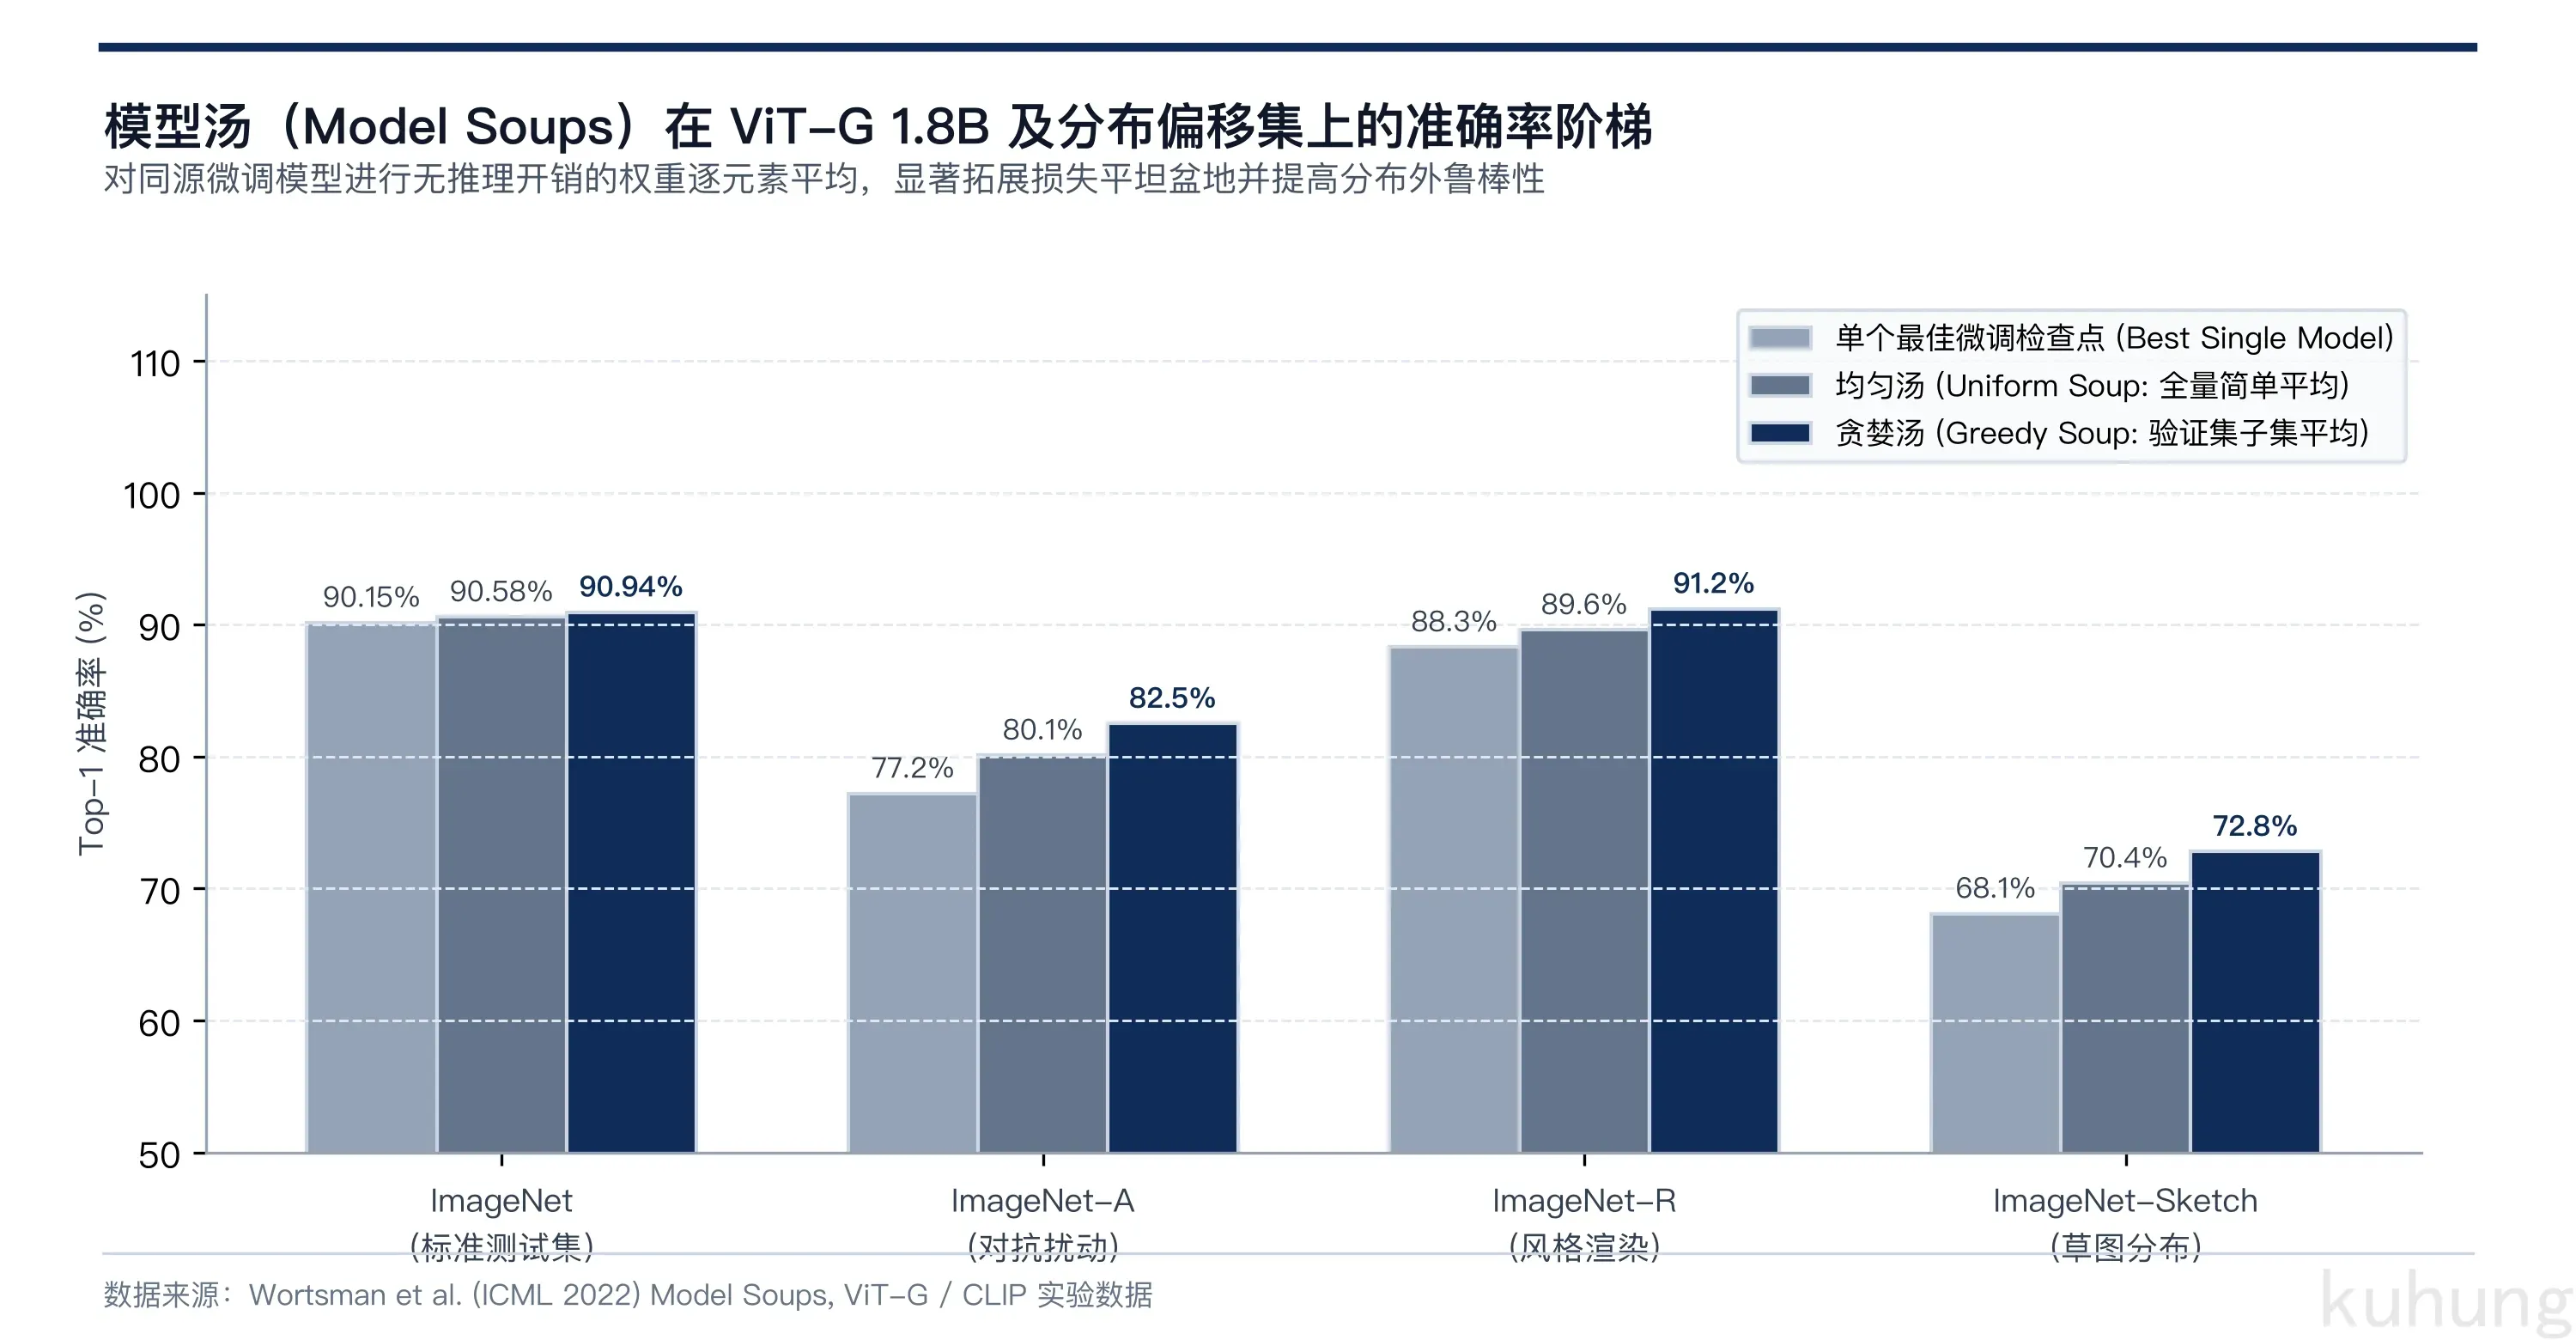
Mitchell Wortsman 等人在 ICML 2022 上的实测数据确立了该技术的性能边界:在包含 18 亿参数的 ViT-G 与多模态 CLIP 模型上,面对 ImageNet 图像分类任务,对 72 个微调模型执行 Greedy Soup 之后,模型的 Top-1 准确率由单个微调最佳的 90.15% 进一步提升至 90.94%,打破了当时该评测集的公开记录。更为显著的优势体现在自然分布偏移测试中:在 ImageNet-A(对抗样本)、ImageNet-R(渲染艺术图)和 ImageNet-Sketch(草图)上,Greedy Soup 的准确率分别达到了 82.50%、91.20% 和 72.80%,较单体最优检查点提升 2 到 5 个百分点。
模型汤在几何上的成立条件在于损失函数曲面的线性连通性(Mode Connectivity)。它要求所有参与平均的检查点必须处于同一个由预训练初始点所决定的损失盆地内部。一旦两个微调模型的初始化不同源,或者内部神经元的排列对称性发生发散,直接取权重平均会导致网络表征崩溃。因此,模型汤无法用于定向的功能缺陷修复或能力重构。
四、机械可解释性:残差流消融与权重吸收
机械可解释性(Mechanistic Interpretability)研究旨在解构 Transformer 内部表征的高维激活空间。研究者普遍采用稀疏自编码器(Sparse Autoencoders, SAEs),在残差流中将高维连续激活分解为具备独立单一语义的方向向量。
Arditi 等人于 2024 年提出的消融术(Abliteration)展现了非梯度行为调控的机制。通过对比语言模型处理恶意/有害提示词与正常提示词时的残差流隐藏状态,计算两组激活均值的差向量(Difference-in-Means),可以从统计学上高信噪比地提取出控制模型“安全拒绝回答”的单一线性方向。
为了避免在推理阶段部署外部钩子进行动态干预,消融术引入了权重吸收(Weight Absorption)机制:基于正交投影原理,将消除该拒绝方向的仿射变换矩阵,直接反向折叠进下游线性层(如 MLP 模块的 down_proj 矩阵或多头注意力的输出投影层)的静态权重张量中。实测数据显示,在 LLaMA-3-8B-Instruct 与 Qwen-7B 上执行该操作后,模型对越狱攻击的拒答率由 95% 以上降至 1% 左右,而在 MMLU(知识问答)和 GSM8K(数学推理)基准上的能力保留率均在 99.5% 以上,未对通用性能造成负面扰动。
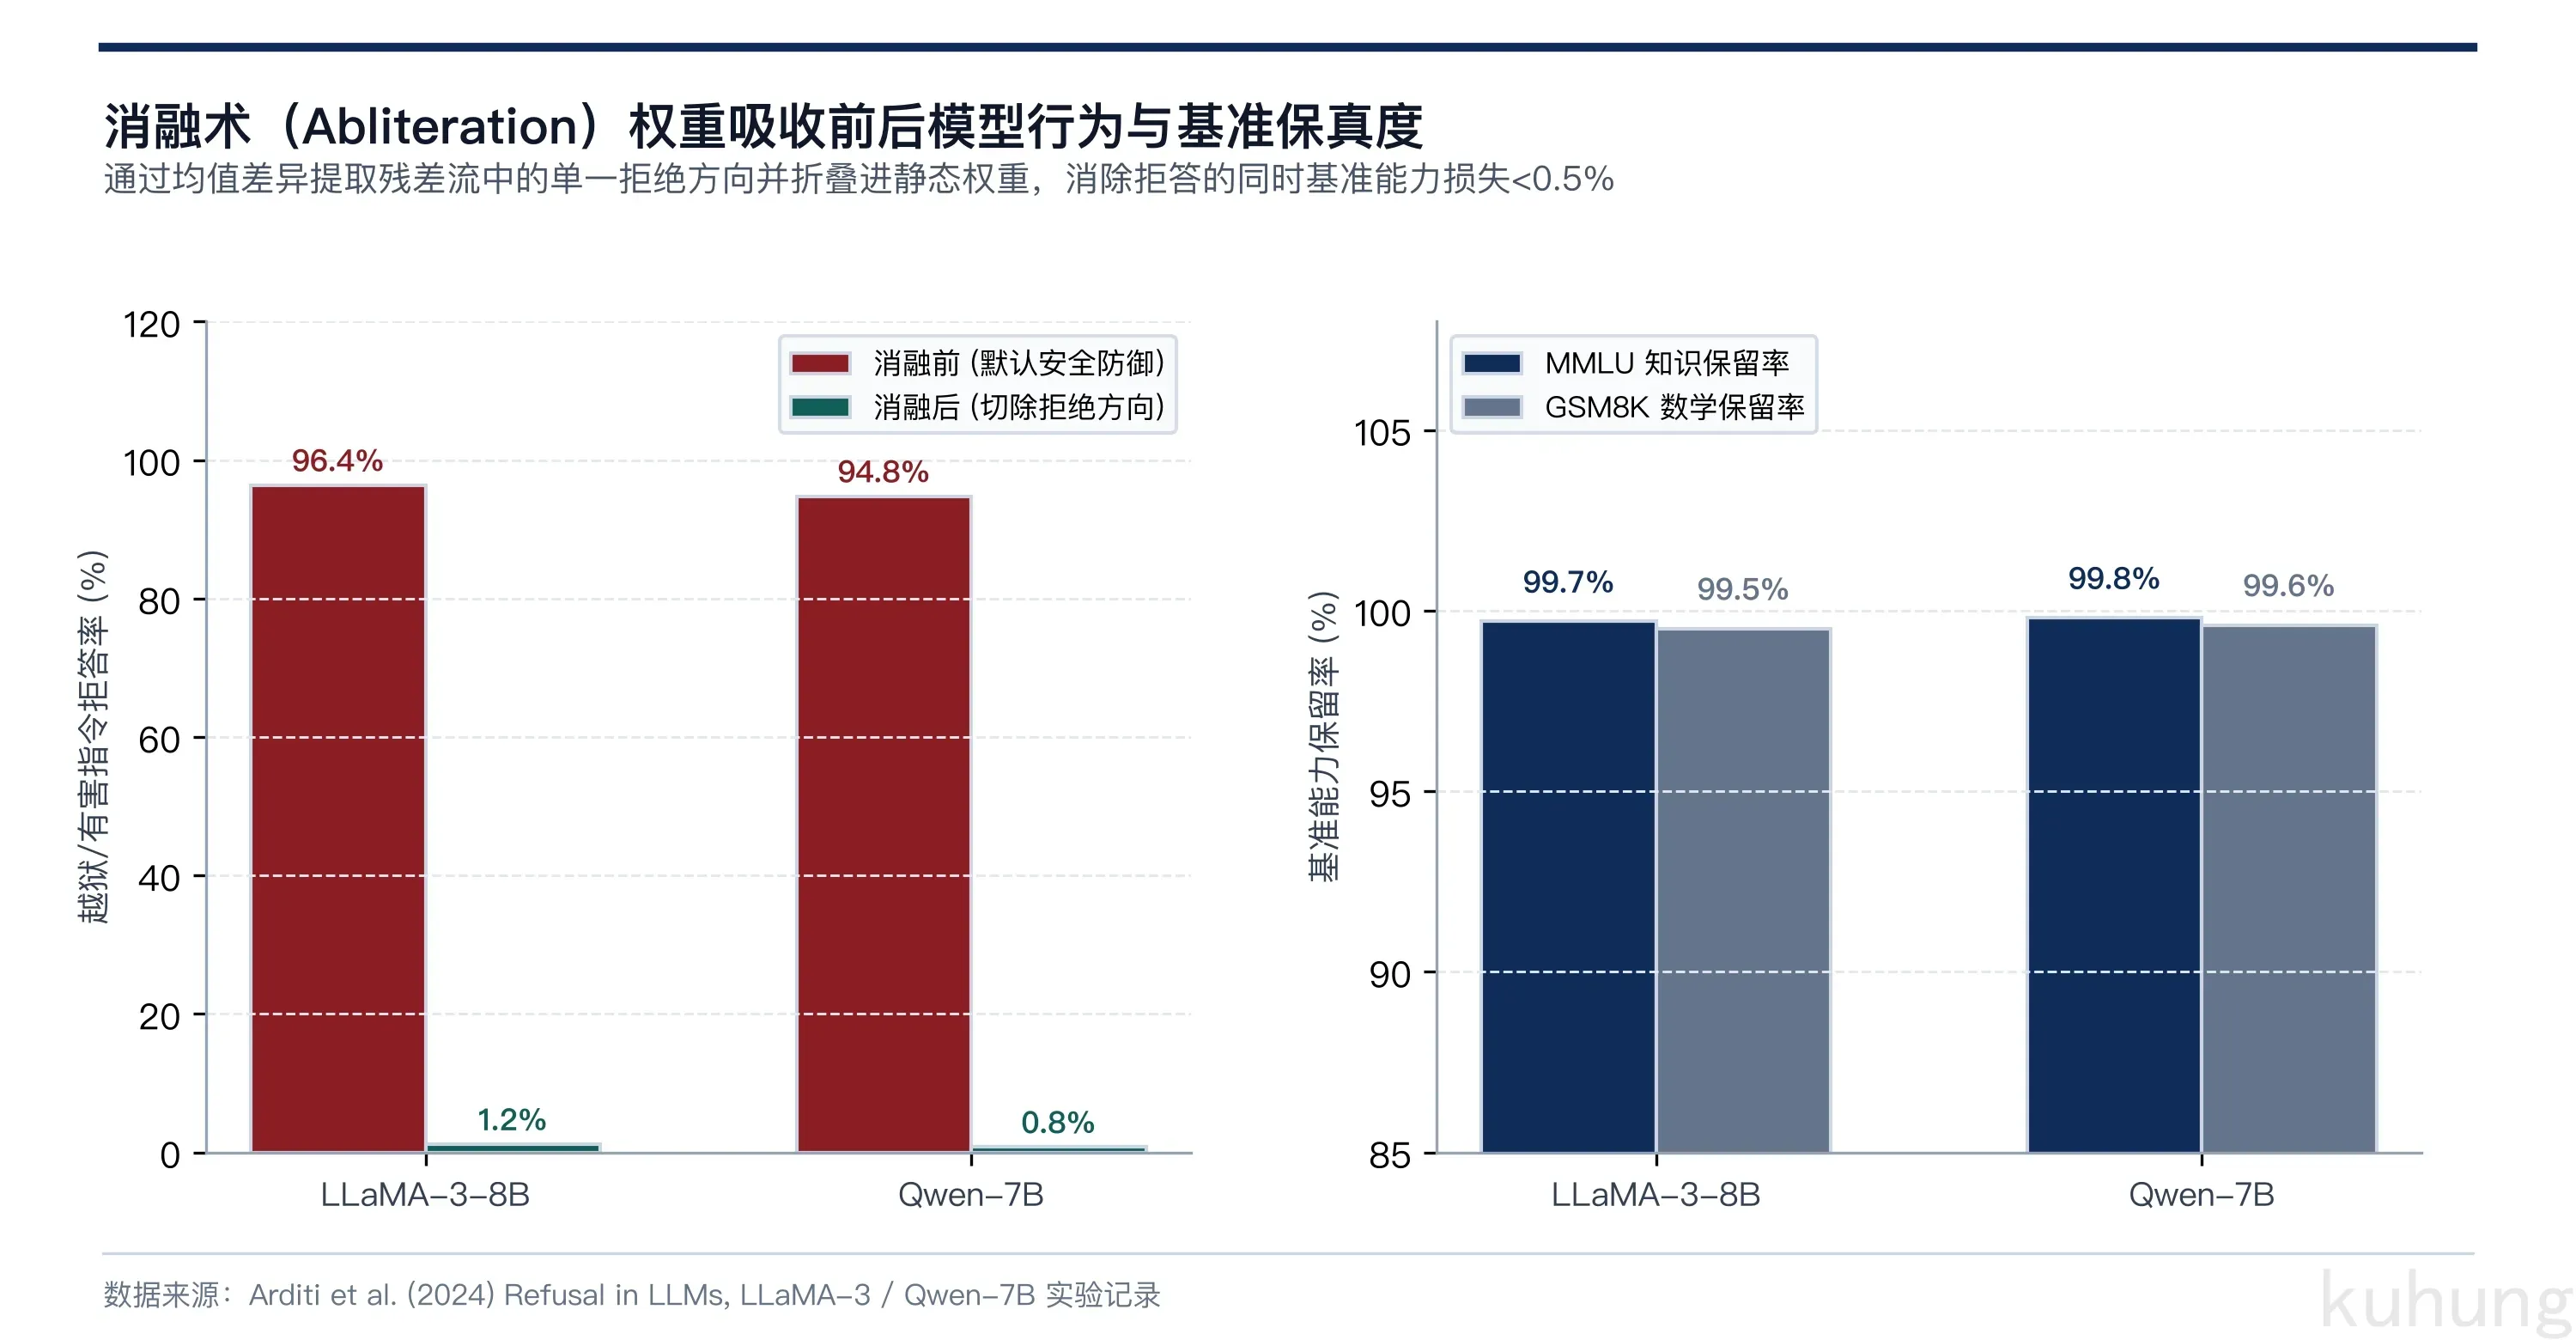
消融术表明高阶行为控制向量可以直接编译为静态参数,但整个探测管线(构建对比数据集、采集激活样本、提取差向量、验证正交投影)完全依赖人类研究员手工编写脚本执行。
五、四大技术路线的结构化对比与演进矩阵
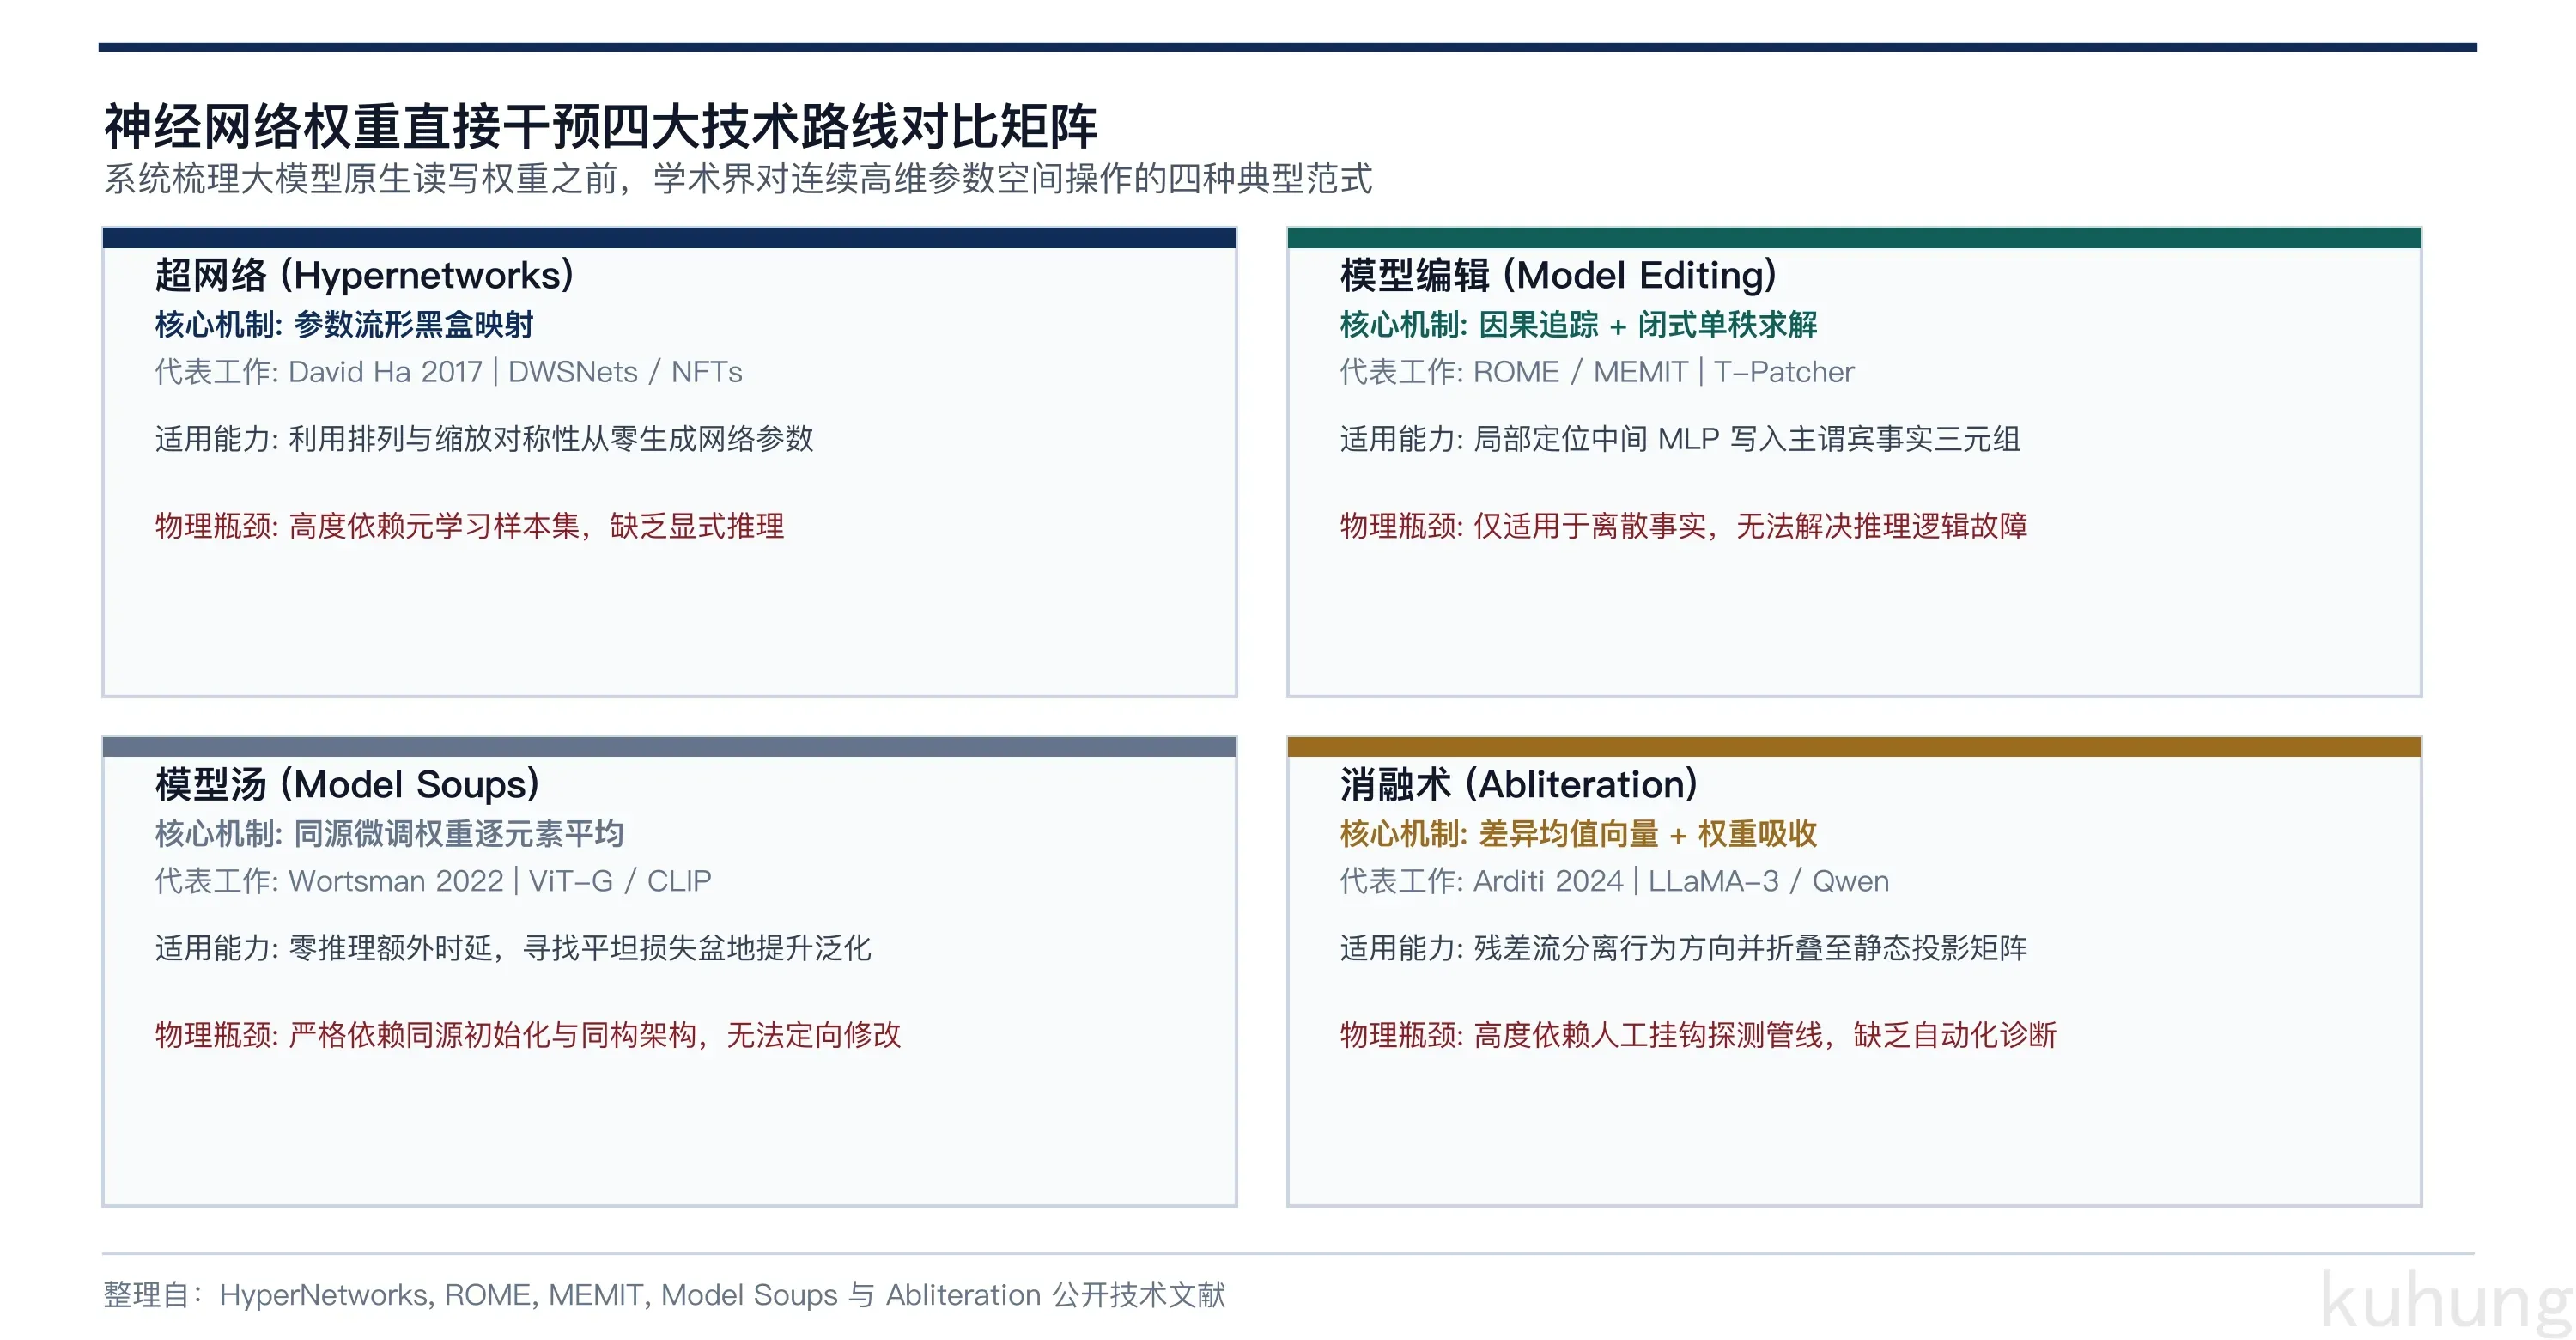
将上述四条技术路线放置于统一的技术坐标系中进行横向审视,可以看出各自的机制差异与应用边界:
| 技术路线 | 核心机制 | 干预粒度 | 关键依赖 | 典型实测基准 | 物理约束边界 |
|---|---|---|---|---|---|
| 超网络 (Hypernetworks) | 参数空间流形映射 | 全网参数动态生成 | 大规模元学习模型样本集 | WMT14 (HyperLSTM) / ARC-1D | 纯统计学黑盒拟合,缺乏显式逻辑推理能力 |
| 模型编辑 (Model Editing) | 因果追踪 + 闭式单秩矩阵更新 | 中间层 MLP 单点/批量修改 | 人工推导的因果干预与解析解 | CounterFact 2.1万条 (ROME, MEMIT) | 局限于主谓宾事实记忆,无法修改动态逻辑缺陷 |
| 模型汤 (Model Soups) | 参数盆地逐元素贪婪平均 | 全参数加权求和 | 严格同源初始化的微调检查点 | ImageNet Top-1 90.94% (ViT-G 1.8B) | 依赖同源与对称性对齐,无法做针对性结构切除 |
| 消融术 (Abliteration) | 均值差向量隔离 + 权重吸收 | 线性投影矩阵降秩正交折叠 | 人工搭建的残差流探测管线 | 越狱拒答消除 / MMLU无损 (LLaMA-3-8B) | 自动化程度低,严重依赖人工实验经验 |
回顾前沿探索之前的技术演进,业内对权重空间的理解正在由早期的“外部监督数值回归”逐步过渡到“内部机制可解释性投影”。然而,不管是闭式矩阵求解还是向量消融,此前始终缺乏一个具备自主代码编写、激活分析与假设检验能力的智能主体。
这也正是 2026 年底 MIT CSAIL 提出权重空间编程(WSP)时,引发行业高度关注的主要切入点。在下篇中,我们将深入剖析大语言模型如何在沙箱环境中自主调度前向探针,以及 Qwen3.5-0.8B 在修改万分之 1.6 的权重后实现数学测试跳变的真实底层物理机理。
参考文献与公开成果源
- Ha, D., Dai, A. M., & Le, Q. V. (2017). HyperNetworks. ICLR 2017.
- Meng, K., Bau, D., Andonian, A., & Belinkov, Y. (2022). Locating and Editing Factual Associations in GPT. NeurIPS 2022.
- Meng, K., Sharma, A. S., Andonian, A., Belinkov, Y., & Bau, D. (2023). Mass-Editing Memory in a Transformer. ICLR 2023.
- Wortsman, M., et al. (2022). Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time. ICML 2022.
- Arditi, A., et al. (2024). Refusal in Language Models Is Mediated by a Single Direction. arXiv:2406.11717.
- Kofinas, M., et al. (2024). Graph Neural Functional Networks for Deep Weight Spaces. ICML 2024.