声明:本文由 AI 辅助创作,经作者核实与修订。
让 AI 写前端或者落地页的时候,经常会遇到一种情况:代码跑得通,布局也齐整,但一眼望过去就是浓重的模型味。紫蓝渐变、大写小眉标、三列等宽特性卡片与假数据,全是网络训练集里的最大公约数。
这种塑料感主要源于模型缺乏具体的设计意图与约束规则。
下面这张图通过本地 Codex 生成,直观比对了两侧的形态差异,并梳理了推荐的去味流程:
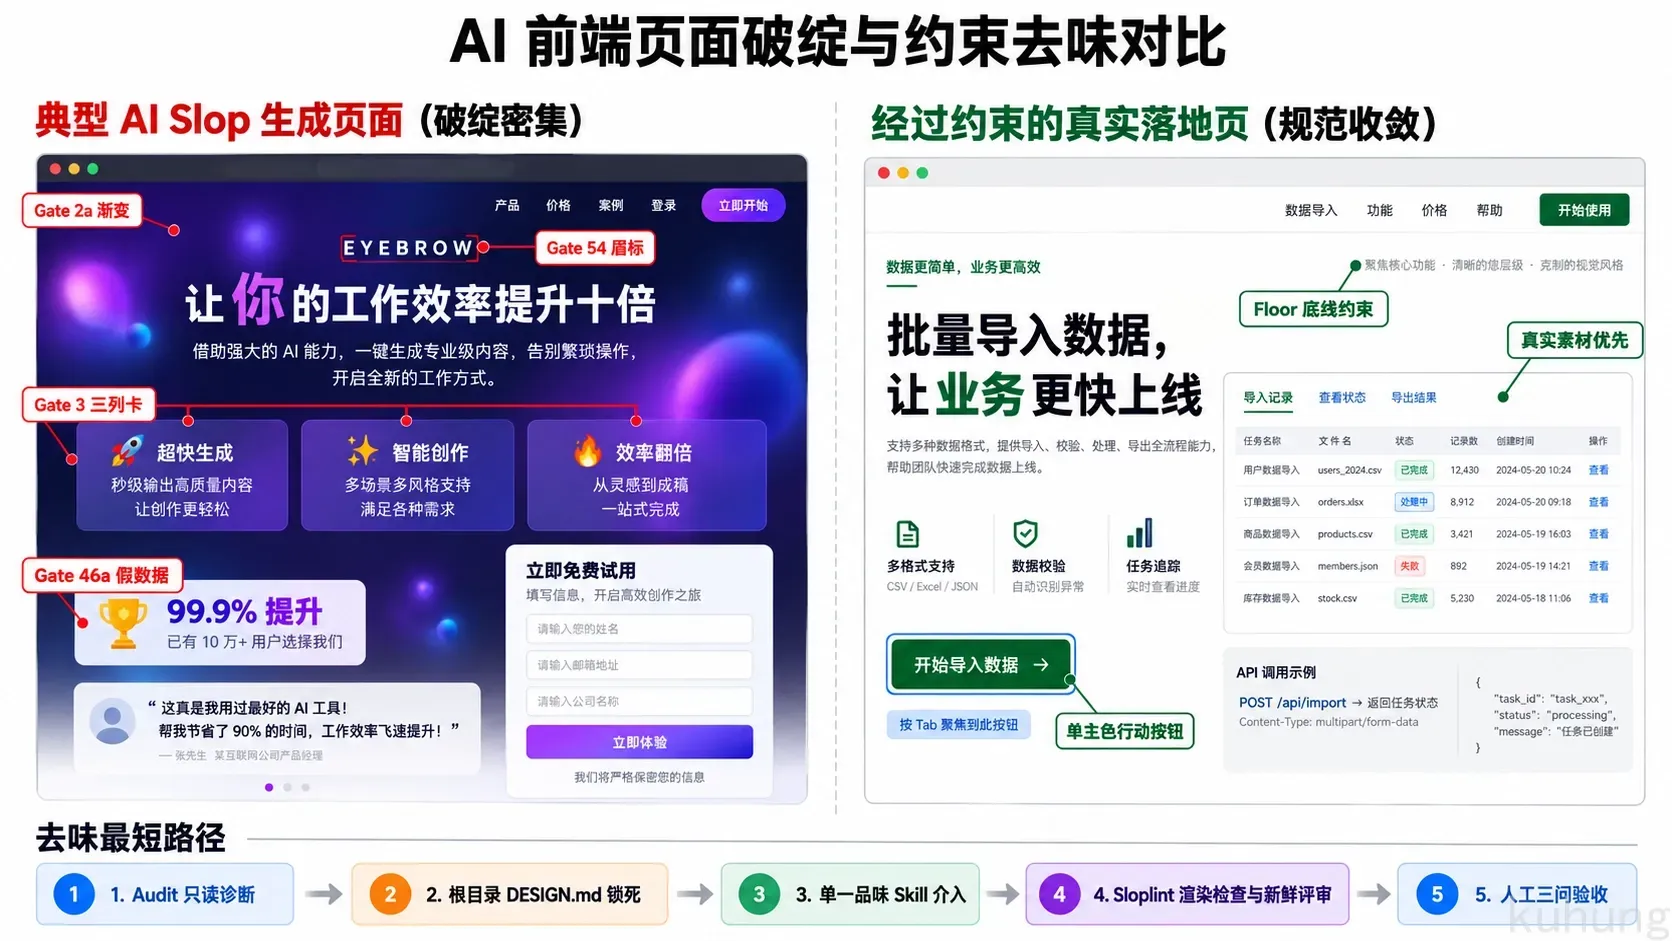
本地 Codex 当前运行环境为默认的 gpt-6.1-sol 模型。图表左侧列出了机器高频生成的视觉套路,右侧给出了经过硬约束后收敛的状态,底部则是推荐的最短去味路径。
一、一眼看穿的 AI 破绽清单
模型在没有得到明确品味指引时,会交出一套在全网训练数据里最常见、最稳妥的组合。开源项目 Hallmark 把这套套路拆解成了具体的规则条款(gates.md),主要分布在四个维度:
- 配色与光效:暗底搭配紫蓝或紫粉渐变,标题文字套用渐变剪切(
background-clip: text),背景散落弥散光斑和发光圆球,或者直接拿框架默认的 indigo/violet 当主品牌色。 - 排版杂音:主标题上方顶一行字号极小的大写英文标签(eyebrow);标题里非要给单个词加斜体或变色;选用 Inter 或 Poppins 当大标题;用中圆点和箭头装点无意义的链接。
- 模板化骨架:顶部首屏,紧接着三列等宽特性卡片(图标加标题加两句话),卡片外层再套边框(卡套卡),底部放通用的邮件订阅框。
- 虚假内容与交互:自动编造“提升 99.9% 效率”的假指标、假用户引言;表单点击后只弹出一个文本提示,背后没有任何数据请求。
| 破绽类别 | 常见机器习惯 | 约束规则的改法 |
|---|---|---|
| 视觉背景 | 紫蓝渐变底、浮动光球、文字渐变 | 纯白或冷灰底,选用单一主色,禁止环境光晕 |
| 排版细节 | 大写小眉标、标题染单个词、等宽小标签 | 删掉眉标,标题文字保持纯色和常规字重 |
| 骨架布局 | 三列等宽卡片、卡套卡、首屏过长 | 按照实际功能定制非对称版式,移除多余卡片框 |
| 交互与内容 | 编造虚假数据、假评价、假表单响应 | 缺少真实素材直接删减区块,表单必须对接真实接口 |
二、Hallmark 是怎么管模型的
Hallmark(GitHub: Nutlope/hallmark)是以 MIT 协议开源的 Agent Skill(技能插件),装在 Cursor、Claude Code、Codex 等辅助编程工具里使用。
在这些工具里,Skill 相当于一套写死的工作规程。它通过四项机制来限制模型的默认发挥:
- 约束分层(Constraint Tiers):
- Floor(底线):十六条不可违背的红线,涵盖键盘焦点环、对比度要求、禁止编造虚假数据,以及禁止大写眉标和卡套卡等家规。底线未过,直接禁止交付。
- Reflex(习惯):针对三列卡片这类模型常犯项。如果业务确实需要,必须在 CSS 头部备注写明条款编号与豁免理由,否则视为违规。
- Finish(修饰):处理引号格式、按钮复用度等细节,只做提示,不阻碍代码合并。
- 先定方向再写代码:先读取项目根目录的
DESIGN.md,一次性问清真实截图与业务受众,从 48 套设计材料中挑选纸张、字体与配色,先产出摘要并单独做首屏,确认无误再铺整页。 - 独立上下文审查员(Fresh Context Reviewer):写代码的那个对话往往对自己的产出过度宽容。Hallmark 在收尾时拉起一个没有历史记忆的新助手,配合无头浏览器工具
sloplint做真实渲染检查,逐项核对约束条款。 - 分级操作指令:提供
/hallmark audit、restyle、polish与redesign多种模式,把诊断与执行解耦。
三、社区与实测的综合评价
任何规则库都有边界。参考海外 Hacker News 上的讨论与厂商实测,开发者对这套体系的看法相对分明。
1. 确实管用的地方
- 把模糊的美感变成了可核对的清单:以往跟 AI 说“要高级、要现代”,AI 往往交出更塑料的页面;Hallmark 的
gates.md把具体的禁令编号,让模型有了执行抓手。 - 只读审计(Audit)适合改造老项目:302.AI 在实测中指出,对于已有的线上页面,直接让 AI 重写容易冲掉原有的业务接线与测试钩子。先运行只读审计,列出视觉、版式结构、文案与交互四类破绽的优先级,再人工决定动哪几处,做法相对稳妥。
- 诊断阶段与执行动作彻底解耦:只读模式不碰代码文件,防止大模型擅自改动全站逻辑,给已有项目保留了退路。
- 内部工具页能拉开区分度:需要大量差异化界面的场景下,这套机制能避免所有内部工具长成同一副模样。
2. 抬不起上限与被质疑的地方
- 容易重新收敛到另一张平均脸:HN 开发者
mstkllah和aleksiy123反馈,不管是用 Hallmark、impeccable 还是其他品味约束插件,只要人类提示词没有给出极端具体的指示,模型在规则约束下依然会收敛到某种特定的平均风格。 - 防重规则在实践中容易失效:Hallmark 项目提交者
opwizardx承认,为了对抗结构重复设置的轮换规则,在实际运行中常常被违反。开发者sixtyj也提到,测试各种 Skill 后,更可控的路径依然是人工手绘草图并喂给多模态模型,纯靠文字约束,LLM 依然会带出机器痕迹。 - 宣传口号与实际表现存在落差:官方口号宣称“终结 AI 味(ends AI slop)”,但社区普遍认为它最多能做到“降低破绽密度”。官方对比演示里自家 linter 报出的“0 issues”,只是内部检查项全部通过的计数,不能当作人类觉得好看的依据。有开发者指出这是“给模板制造者准备的防模板工具”。
- 底座模型决定观感上限:约束层本质上是过滤器与代码检查器。底层模型的设计理解能力不够时,约束层无法凭空拔高审美上限。
四、给自己产品去味的五步操作
结合独立设计师 Carlos Lastres 的建议与实际工程经验,建议采用以下五步推进去味:
1. 梳理禁止清单写进 DESIGN.md
在代码仓库根目录放一个简短的文件,明确视觉风格与禁令,把打勾的破绽写死:
产品定位:团队内部开票工具
视觉取向:冷峻、公文纸张感,严禁创业公司热闹风格
字体:系统默认无衬线字体,禁止 Inter、Poppins
配色:单一深墨绿,禁止紫蓝渐变,禁止毛玻璃拟态
排版:默认左对齐,禁止三列等宽特性卡
Banned 清单:眉标、标题单字变色、假数据、假评价、emoji 图标
注意:遇到规则冲突必须先询问,严禁自行豁免底线条款
2. 避免叠加多个品味插件
不要同时装 Hallmark、impeccable 等多个同类型插件。规则打架会让输出退化回折中的平庸状态。选定一套规则,或者直接使用手写的 DESIGN.md。
3. 改旧页面严格遵循分级动作
- 只读摸底:优先运行审计命令,只出诊断报告,不修改任何代码。
- 轻量微调(Polish):结构不动,仅清理对比度、设计变量和破绽细节。
- 局部换肤(Restyle):布局不动,替换色盘、字体、圆角与阴影。
- 全面重构(Redesign):原页面彻底是模板骨架时才全量重写,重写前必须记录所有表单字段与接口,避免丢失功能。
4. 准备真实素材,两轮截图闭环
没有真实数据就直接砍掉数字牌,没有用户评价就删掉引言区。给模型提供真实的界面截图和可商用素材。
在手机与桌面两种宽度下截图检查,对照设计文件只改排名前几的问题,两轮调整后停手。
5. 人工三问自检
自动化工具报零错误后,由人工看三点:
- 五秒内能不能看清字号层级?
- 界面里的醒目主色,能否唯一对应那个主要操作按钮?
- 把 Logo 遮住后,还能不能认出这是你自己的产品?
五、对做产品与做 Bot 的启示
对于做日常工具或做 Bot 的开发者,Hallmark 值得搬过来的是它的约束层工程化思路:
- 把模糊的审美要求翻译成可量化、可代码检查的规则清单;
- 把只读诊断阶段与代码修改阶段彻底解耦;
- 建立自动化渲染检查与无记忆独立评审流程;
- 坚持真实素材优先,用负向清单锁死默认习惯。
把“破绽密度下降”、“全局设计变量统一”、“表单与交互状态完备”以及“无障碍底线达标”四项作为交付指标,远比承诺“消灭 AI 味”更符合工程实际。
关注我的其他账号
如果这篇文章对你有用,欢迎分享给也关心前端开发与 AI 工具的朋友。后续的技术实践、Agent 工作流与产品分析,也会发在下面这些账号:
- 微信公众号:谷粒粒,在微信搜索「谷粒粒」,或点击查看公众号二维码。
- 小红书:谷粒粒。
- 知乎:谷粒。
- Twitter / X:kuhung(@kuhungio)。

谷粒 · KUHUNG